Dạy AI nhận ra người trong ảnh nhiệt UAV ban đêm
Trong cứu hộ sau động đất hay sạt lở, “72 giờ vàng” không phải là một khẩu hiệu — nó là một đường cong tử vong. Dữ liệu từ trận động đất Kobe 1995 mà nhóm tác giả trích dẫn cho thấy xác suất sống sót của người cần cứu giảm rất nhanh: từ khoảng 75% ngay trong ngày xảy ra thảm họa, xuống còn khoảng 24% sau một ngày, và chỉ còn khoảng 5% sau 72 giờ. Vấn đề là phần lớn khung giờ vàng đó rơi vào ban đêm — khi tầm nhìn kém khiến các hướng dẫn an toàn quốc tế (như của INSARAG) buộc lực lượng cứu hộ phải thu hẹp hoặc tạm dừng hoạt động hiện trường. Một nghiên cứu vừa công bố trên tạp chí Remote Sensing (MDPI) của nhóm tác giả tại Đại học Kagawa (Nhật Bản) nhắm thẳng vào khoảng trống này: phát hiện tự động nạn nhân từ ảnh nhiệt hồng ngoại chụp bởi UAV vào ban đêm.
Vấn đề không nằm ở thuật toán, mà ở dữ liệu
Bài toán nghe đơn giản — dùng AI nhận diện người trong ảnh nhiệt — nhưng cái khó thực sự nằm ở chỗ gần như không có đủ dữ liệu ảnh nhiệt chụp từ UAV tại hiện trường thảm họa để huấn luyện mô hình, đặc biệt là các tư thế đặc trưng của nạn nhân (nằm, cúi, bị vùi một phần). Ảnh vệ tinh có thể quan sát diện rộng cả ban đêm nhưng độ phân giải quá thấp để nhận ra từng người. Nhóm tác giả giải quyết nút thắt này bằng một ý tưởng thực dụng: dùng camera nhiệt cố định đặt trên mặt đất — thứ dễ thu thập an toàn và rẻ hơn nhiều so với việc bay UAV thật tại hiện trường — làm nguồn dữ liệu huấn luyện thay thế.
Nhưng ảnh chụp từ camera mặt đất và ảnh chụp từ UAV bay ở độ cao 20 m khác nhau rất nhiều về góc nhìn và tỷ lệ: một người trong ảnh UAV chỉ chiếm vài chục pixel, trong khi cùng người đó đứng gần camera mặt đất có thể chiếm diện tích lớn hơn nhiều lần. Đây chính là “khoảng cách miền” (domain gap) mà nhóm tác giả phải thu hẹp trước khi dữ liệu mặt đất có thể dùng để huấn luyện mô hình nhận diện cho ảnh UAV.
Ba bước xử lý để “biến” ảnh mặt đất thành ảnh UAV
Giải pháp kỹ thuật cốt lõi của bài báo gồm ba bước xử lý ảnh liên tiếp. Đầu tiên, thu nhỏ không gian (spatial resizing): tính tỷ lệ thu nhỏ dựa trên chiều cao pixel của người trong ảnh UAV so với ảnh mặt đất, rồi thu nhỏ ảnh mặt đất theo đúng tỷ lệ đó để mô phỏng kích thước một người khi nhìn từ trên cao. Thứ hai, đệm nền (padding): đặt ảnh đã thu nhỏ vào giữa một nền đen kích thước bằng đầu vào của mô hình, mô phỏng vùng nhiệt độ thấp bao quanh mà UAV thường “nhìn thấy” từ trên không. Thứ ba, tăng cường theo vị trí (position-based augmentation): thay vì luôn đặt người ở giữa khung hình, nhóm tác giả tạo thêm bốn phiên bản với người được đặt ở bốn góc ảnh — nhân dữ liệu huấn luyện từ 1.827 lên 9.135 ảnh mà không cần thu thập thêm.
Mô hình được chọn để huấn luyện là Grounding DINO — một kiến trúc nhận diện vật thể dựa trên Transformer, kết hợp bộ mã hóa hình ảnh (Swin Transformer) với bộ mã hóa văn bản (BERT), cho phép “chỉ định” đối tượng cần tìm bằng một câu lệnh văn bản thay vì phải huấn luyện lại cho từng loại đối tượng mới. Nhóm tác giả chọn từ khóa đơn giản “person” sau khi thử nghiệm cho thấy các từ khóa liên quan thảm họa như “victim” hay tổ hợp nhiều từ khóa lại cho kết quả kém ổn định hơn.
Kết quả: cải thiện rõ nhất ở nơi khó nhất
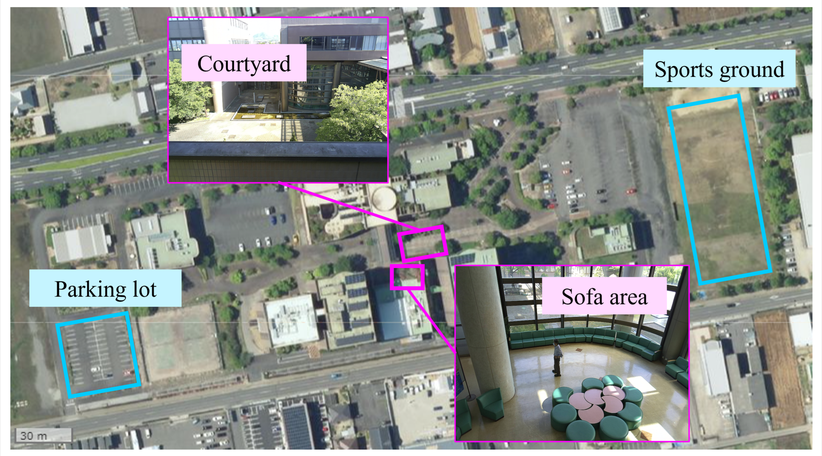
Điểm thú vị là mô hình sau tinh chỉnh không cải thiện nhiều ở bãi đỗ xe — nơi nền nhiệt độ tương đối đồng đều và mô hình gốc (chưa huấn luyện thêm) vốn đã hoạt động khá tốt. Nhưng ở sân thể thao — nơi cỏ và đất trộn lẫn tạo ra nhiễu nhiệt phức tạp — độ hồi tưởng (recall) của mô hình gốc chỉ đạt 8%, trong khi mô hình đã qua huấn luyện đạt 40%, tức gấp năm lần. Ở kịch bản khó nhất — sân thể thao có đặt vật cản như bìa carton mô phỏng người bị vùi lấp một phần — mô hình gốc gần như thất bại hoàn toàn (độ chính xác, độ hồi tưởng và F1-score đều chỉ khoảng 7%), trong khi mô hình đã huấn luyện vẫn duy trì được khả năng nhận diện các phần cơ thể lộ ra như đầu và chân tay.
Thí nghiệm cắt lát từng thành phần xử lý cho thấy bước đệm nền và tăng cường theo vị trí đóng góp nhiều nhất vào cải thiện hiệu năng ở các môi trường khó, trong khi riêng bước thu nhỏ không gian gần như không tạo khác biệt nếu đứng một mình.
Không chỉ là kiến trúc Transformer
Một phát hiện đáng chú ý là khi so sánh với YOLOv8n (mô hình CNN nhẹ, phổ biến) và RT-DETR (một mô hình Transformer thời gian thực khác) được huấn luyện trên cùng bộ dữ liệu đã xử lý, cả hai đều gần như thất bại hoàn toàn ở sân thể thao và sân có vật cản — độ chính xác trung bình gần bằng 0. Điều này cho thấy sự vượt trội của Grounding DINO không đơn thuần đến từ kiến trúc Transformer, mà đến từ các “định kiến ngữ nghĩa” (semantic priors) mà mô hình học được từ việc huấn luyện trước trên lượng lớn dữ liệu ảnh-văn bản — một lợi thế mà các bộ phát hiện “tập kín” (closed-set) như YOLO hay RT-DETR không có.
Về tốc độ, Grounding DINO xử lý khoảng 24 khung hình/giây trên GPU cấp máy trạm — đủ cho xử lý gần thời gian thực tại trạm mặt đất, dù chậm hơn nhiều so với 457 khung hình/giây của YOLOv8n. Nhóm tác giả cũng thử nghiệm mở rộng trên dữ liệu ban đêm thật và trên một bộ dữ liệu công khai độc lập (HIT-UAV) chụp ở độ cao 60–130 m — cao hơn nhiều so với 20 m mà mô hình được huấn luyện. Kết quả cho thấy mô hình bị “chuyên biệt hóa” quá mức vào tỷ lệ kích thước người ở độ cao huấn luyện, nhưng có thể phục hồi phần lớn hiệu năng chỉ bằng cách điều chỉnh lại độ phân giải đầu vào theo độ cao bay thực tế — không cần huấn luyện lại.
Vì sao đáng chú ý
Với người theo dõi UAV ứng dụng trong cứu hộ, giá trị lớn nhất của nghiên cứu này nằm ở chiến lược xây dựng dữ liệu chứ không phải bản thân thuật toán nhận diện — như chính nhóm tác giả nhấn mạnh. Việc chứng minh rằng dữ liệu camera nhiệt mặt đất, vốn dễ và rẻ để thu thập, có thể thay thế cho dữ liệu UAV thật khan hiếm và tốn kém mở ra một hướng đi thực tế cho các đội cứu hộ hoặc tổ chức nghiên cứu không có điều kiện bay thử nghiệm quy mô lớn tại hiện trường thảm họa. Đồng thời, phát hiện về việc hiệu năng suy giảm khi thay đổi độ cao bay — nhưng có thể phục hồi bằng cách điều chỉnh tỷ lệ đầu vào — là một bài học vận hành cụ thể: bất kỳ ai triển khai mô hình tương tự cần đồng bộ giữa độ cao bay thực tế và cách mô hình được huấn luyện hoặc hiệu chỉnh.
Với bối cảnh Việt Nam — nơi thiên tai như sạt lở, lũ quét thường xảy ra vào ban đêm hoặc kéo dài qua đêm, và nguồn lực bay thử nghiệm UAV tại hiện trường thật gần như không có — cách tiếp cận “huấn luyện từ dữ liệu mặt đất, triển khai trên không” là một mô hình đáng cân nhắc để xây dựng năng lực nhận diện nạn nhân ban đêm mà không cần chờ tích lũy đủ dữ liệu UAV thật từ các thảm họa đã qua.
Nguồn: Kubo, S.; Yamada, K.; Yoshida, H. “Automated Victim Detection from UAV Thermal Infrared Imagery for Nighttime Search and Rescue Using Multi-Pose Ground Camera Data.” Remote Sensing 2026, 18(14), 2279. DOI: 10.3390/rs18142279.