Dạy một đàn UAV tự học cách tìm người trong đám cháy rừng
Phần lớn nghiên cứu về UAV tìm kiếm cứu nạn (SAR) từ trước tới nay đặt ra một giả định khá xa thực tế: biết trước vị trí nạn nhân, và môi trường tĩnh, không đổi trong lúc UAV bay tới. Với cháy rừng — nơi đám cháy lan theo thời gian thực, đường đi trước đó vừa được lập đã có thể lỗi thời — giả định này gần như vô nghĩa. Một nghiên cứu vừa công bố trên tạp chí Neurocomputing (Elsevier) của nhóm tác giả tại Đại học Cranfield (Anh) đề xuất một hướng đi khác: dùng học tăng cường sâu đa tác nhân (multi-agent deep reinforcement learning) để huấn luyện cả một đội UAV tự học cách khám phá khu rừng đang cháy và tìm ra những ngôi nhà — cùng những người — đang bị đe dọa, mà không cần biết trước vị trí của họ.
Hai câu hỏi cốt lõi
Nhóm tác giả đặt vấn đề bằng hai câu hỏi rất cụ thể: UAV nên khám phá khu vực cháy rừng như thế nào cho hiệu quả, và làm sao UAV biết người cần cứu đang ở đâu để sơ tán kịp trước khi lửa lan tới. Đây không phải bài toán đường bay tối ưu theo nghĩa cổ điển (có bản đồ, có đích đến cố định), mà là bài toán khám phá một môi trường không biết trước, đang biến đổi liên tục — chính là điểm khiến các thuật toán lập kế hoạch đường đi truyền thống trở nên kém hiệu quả.
Một khu rừng “thật” hơn: mật độ thực vật không đồng đều
Điểm khác biệt đầu tiên của nghiên cứu nằm ở cách mô hình hóa khu rừng. Phần lớn các mô hình trước đây giả định mật độ thực vật đồng đều trên toàn bộ khu vực, khiến đám cháy lan ra theo hình tròn đối xứng — một hình dạng không phản ánh đúng thực tế. Nhóm tác giả xây dựng một lưới ô vuông 100×100, trong đó mỗi ô có mật độ thực vật riêng, được tạo ra bằng phép tích chập Gauss để có sự biến thiên tự nhiên nhưng không rời rạc vô lý. Kết quả là đám cháy mô phỏng có viền lửa mỏng, không liên tục và hình dạng phức tạp — khó dự đoán hơn nhiều so với các mô hình lan tỏa hình tròn kinh điển, và vì thế cũng là một bài kiểm tra khó hơn cho các thuật toán học tăng cường.
Đám cháy được mô hình hóa như một chuỗi Markov cục bộ tại mỗi ô: một ô khỏe mạnh có xác suất bắt lửa phụ thuộc vào số ô lân cận đang cháy và mật độ thực vật của chính nó; một ô đang cháy có xác suất tắt lửa theo phân phối hình học; một ô đã cháy hết thì giữ nguyên trạng thái “chết” vĩnh viễn. Cách thiết lập này cho phép mô phỏng hàng nghìn kịch bản cháy rừng khác nhau với chi phí tính toán thấp.
Cảm biến nhiệt độ thay cho camera: một lựa chọn có chủ đích
Một quyết định thiết kế đáng chú ý là nhóm tác giả không dùng camera thị giác làm nguồn quan sát chính cho UAV, vì camera dễ cho kết quả dương tính giả do điều kiện ánh sáng hoặc bị che khuất bởi khói. Thay vào đó, họ mô hình hóa một lưới nhiệt độ lan tỏa và nguội dần theo thời gian quanh đám cháy, phản ánh cách cảm biến nhiệt gắn trên UAV thực tế sẽ “nhìn thấy” hiện trường. Cách tiếp cận này vừa thực tế hơn (nhiệt là tín hiệu ổn định hơn ánh sáng trong môi trường khói bụi), vừa nhẹ về mặt tính toán so với việc giải phương trình truyền nhiệt đầy đủ.
Kiến trúc học: chia sẻ khi huấn luyện, tự quyết khi hành động
Nhóm tác giả sử dụng mạng Q sâu đa tác nhân (MADQN) theo khung “huấn luyện tập trung, thực thi phân tán” (CTDE): trong lúc huấn luyện, các UAV chia sẻ thông tin toàn cục về môi trường và kinh nghiệm bay; nhưng khi vận hành thực tế, mỗi UAV chỉ dùng bản sao mạng nơ-ron của riêng mình để tự ra quyết định, không cần liên lạc liên tục. Đầu vào cho mỗi UAV bao gồm: một “bản đồ hiện diện” cho biết khu vực nào đã được khám phá nhiều (để tránh dẫm chân lên đường bay của chính mình hoặc UAV khác), vị trí tương đối so với điểm phát cháy ban đầu, tốc độ di chuyển hiện tại, và vị trí của UAV gần nhất. Không gian hành động đơn giản gồm 8 hướng di chuyển.
Hàm thưởng được thiết kế thành bốn thành phần cộng lại: thưởng khi phát hiện một ngôi nhà còn an toàn (thưởng cao hơn nếu nhà gần điểm phát cháy — nơi rủi ro cao nhất), thưởng khi di chuyển vào vùng ít được khám phá, thưởng theo tốc độ di chuyển (khuyến khích bay nhanh, quét rộng), và thưởng khi giữ khoảng cách hợp lý với UAV khác để tránh chồng lấn vùng khám phá. Khi phát hiện một ngôi nhà, UAV được giả định dừng lại 20 bước thời gian để “định vị và sơ tán” người trong nhà — dù bản thân quá trình sơ tán không được mô phỏng chi tiết, chỉ đơn giản là UAV ngừng di chuyển trong khoảng thời gian đó.
Kết quả: học được, nhưng chưa vượt trội áp đảo
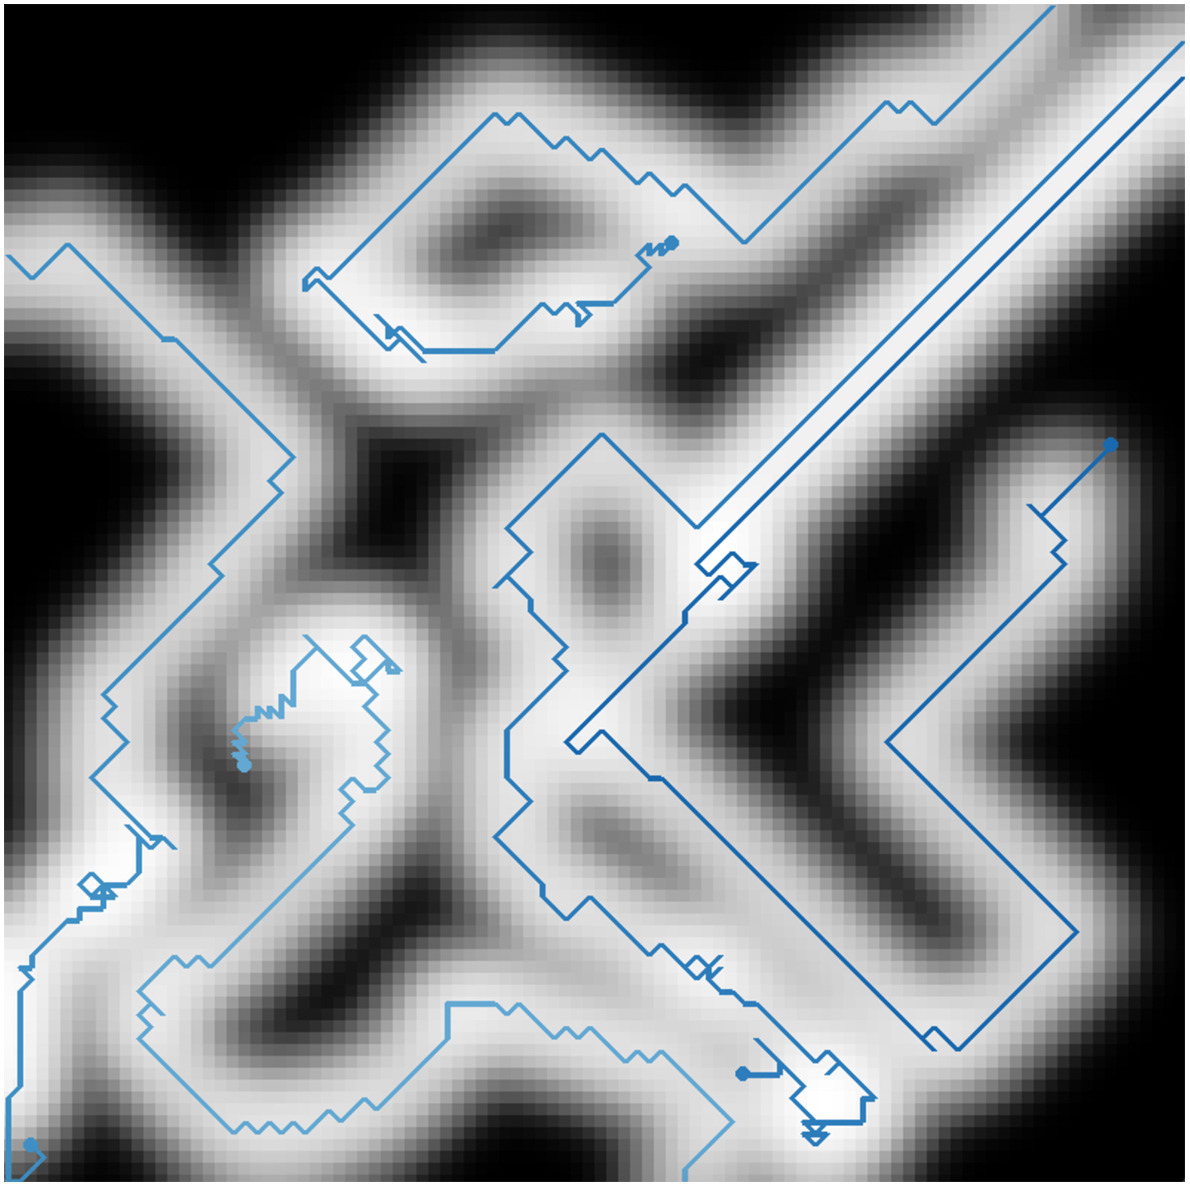
Với đội hình 5 UAV, mô hình MADQN sau huấn luyện đạt điểm số trung bình tương đương việc phát hiện và “thăm” được khoảng 46% số nhà còn an toàn trước khi đám cháy kết thúc, so với 38% của một thuật toán heuristic đơn giản được thiết kế riêng để so sánh — một mức cải thiện khoảng 8 điểm phần trăm. Đường cong phần thưởng cho thấy các UAV học cách lao về trung tâm bản đồ trước (nơi phần thưởng phát hiện nhà cao nhất do gần điểm phát cháy), sau đó tách ra khỏi vùng đã cháy, di chuyển theo đường thẳng (tốc độ cao) và ưu tiên các vùng chưa được khám phá.
Các thí nghiệm cắt lát cho thấy tham số kiểm soát kích thước “vùng hiện diện” và độ trễ khi tính toán bản đồ hiện diện đều ảnh hưởng rõ đến kết quả — vùng quá nhỏ khiến UAV không nhận biết được mình đã đi qua đâu, vùng quá lớn thì làm mất thông tin chi tiết. Đáng chú ý, số lượng UAV càng tăng thì điểm số càng cải thiện, và khoảng cách hiệu năng giữa MADQN và thuật toán heuristic được duy trì nhất quán ở mọi quy mô đội hình.
Những gì mô hình chưa làm được
Bài báo minh bạch về giới hạn của một mô hình đầu tiên trong lĩnh vực này: chưa tính đến gió, độ ẩm, thời lượng pin, hay nhiễu/độ trễ trong đo lường cảm biến — tất cả những yếu tố vốn ảnh hưởng lớn đến vận hành UAV thực tế. Việc mô phỏng “sơ tán” cũng chỉ dừng ở mức trừu tượng (UAV dừng 20 bước), chưa mô hình hóa việc truyền thông tin vị trí về cho lính cứu hỏa hay việc điều phối nguồn lực cứu hộ trên mặt đất. Nhóm tác giả xem đây là hướng mở cho các nghiên cứu tiếp theo, bao gồm cả việc tối ưu hóa thời gian “dừng sơ tán” và tích hợp cơ chế học có con người trong vòng lặp.
Vì sao đáng chú ý
Với người quan tâm đến UAV ứng dụng trong phòng chống cháy rừng, giá trị chính của nghiên cứu này không nằm ở con số 46% hay 8 điểm phần trăm cải thiện, mà ở cách đặt lại bài toán: thay vì giả định biết trước vị trí nạn nhân và môi trường tĩnh — điều gần như không bao giờ đúng trong một đám cháy thực — nhóm tác giả xây dựng một môi trường mô phỏng đủ phức tạp (mật độ thực vật không đồng đều, viền lửa bất định) để buộc thuật toán học cách khám phá một cách thích ứng. Đây là hướng tiếp cận đáng theo dõi cho các khu vực có nguy cơ cháy rừng theo mùa, nơi việc triển khai một đội UAV tự học thăm dò khu vực rộng, khó tiếp cận có thể bổ sung hiệu quả cho nguồn lực cứu hỏa mặt đất vốn luôn hạn chế về nhân lực và thời gian phản ứng.
Nguồn: Collignon, M.; Perrusquía, A.; Tsourdos, A.; Guo, W. “Search and rescue operations in wildfires using unmanned aerial vehicles: A multi-agent deep reinforcement learning approach.” Neurocomputing, Vol. 653, 2025, Article 131211. DOI: 10.1016/j.neucom.2025.131211.